Знаете это чувство, когда модель на тренировочных данных показывает почти идеальную точность, а при первом же столкновении с реальностью начинает выдавать полный бред? Или наоборот - алгоритм настолько прост, что не видит очевидных закономерностей, которые заметил бы даже стажер? Это классические симптомы неправильно откалиброванной сложности. В мире машинного обучения и статистики поиск «золотой середины» между слишком простой и слишком умной моделью - это не просто академическая задача, а вопрос выживания проекта.
Давайте честно: никто не хочет строить модель, которая либо игнорирует данные (недообучение), либо запоминает шум вместо сигналов (переобучение). Калибровка сложности - это процесс настройки уровня детализации вашей модели так, чтобы она максимально точно предсказывала новые данные, сохраняя способность к обобщению. Если вы работаете с данными, будь то маркетинговая аналитика или финансовые прогнозы, понимание того, где находится ваш оптимальный порог сложности, сэкономит вам часы дебаггинга и нервы заказчиков.
Почему мы постоянно ошибаемся в оценке сложности
Проблема калибровки возникает из-за фундаментального конфликта двух целей. С одной стороны, нам нужно, чтобы модель хорошо описывала обучающую выборку. С другой - она должна быть достаточно гибкой, чтобы работать на новых данных, но достаточно строгой, чтобы не подстраиваться под случайные выбросы. Представьте себе попытку нарисовать карту города. Если вы используете только прямые линии для всех дорог (низкая сложность), карта будет бесполезной. Но если вы начнете прорисовывать каждую трещину в асфальте и каждый лист на деревьях (высокая сложность), карта станет неподъемной и потеряет навигационную ценность.
В статистике это явление известно как дилемма смещения и дисперсии. Недообученная модель имеет высокое смещение (bias): она систематически ошибается, потому что ее структура слишком примитивна для захвата реальных зависимостей. Переобученная модель имеет высокую дисперсию (variance): она хаотично реагирует на малейшие изменения в обучающих данных, включая случайный шум. Ваша задача как специалиста - найти точку, где сумма этих ошибок минимальна.
Как выглядит ошибка: визуализируем проблему
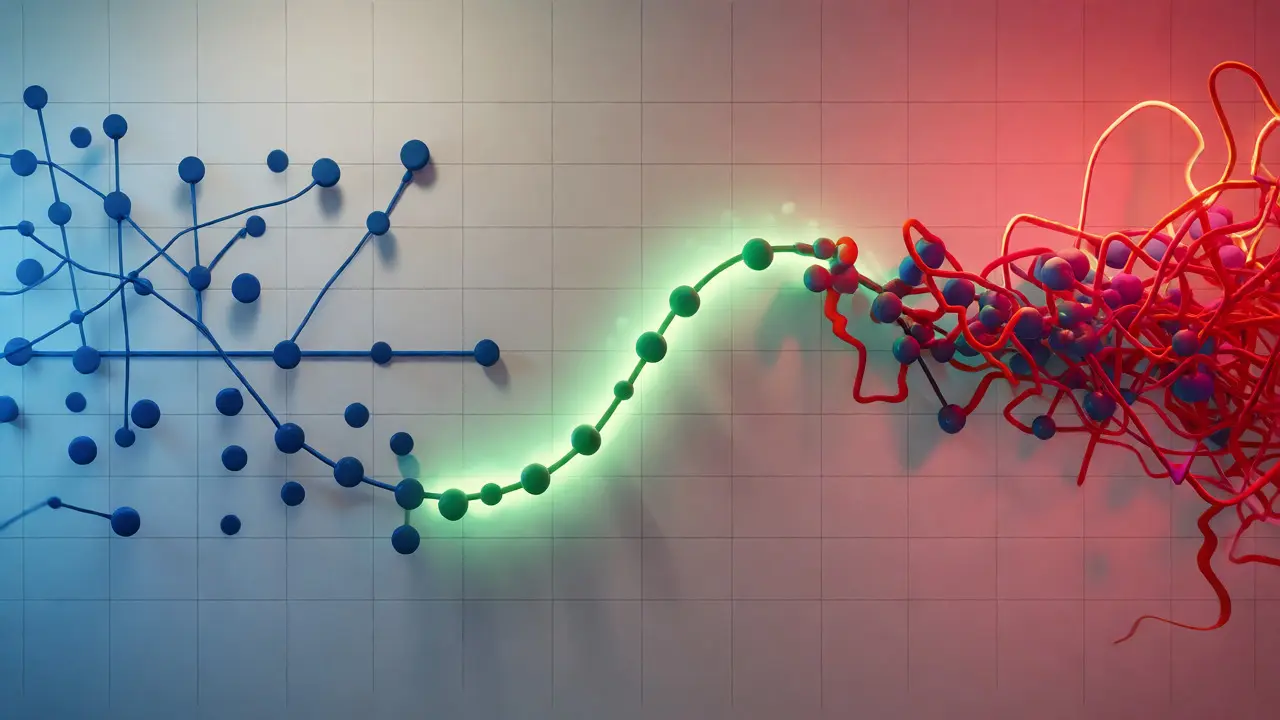
Чтобы понять, куда движется ваша модель, посмотрите на графики ошибок. Обычно используют два показателя: среднеквадратичную ошибку обучения (RMSEC) и ошибку проверки (RMSEP). RMSEC всегда снижается по мере усложнения модели. Это логично: чем больше параметров у модели, тем лучше она может подогнать себя под конкретные точки обучающего набора. Даже если вы добавите полином 100-й степени, он пройдет через все ваши точки.
Но вот с RMSEP история совсем другая. Сначала, когда вы увеличиваете сложность, ошибка на проверочных данных падает - модель становится умнее и начинает видеть настоящие закономерности. Но в какой-то момент график разворачивается вверх. Это точка перелома. После нее каждое дополнительное усложнение не улучшает прогноз, а ухудшает его, потому что модель начинает учить шум. Оптимальная сложность находится ровно в точке минимума кривой RMSEP. Пропустите этот момент - и получите хрупкую модель, которая сломается при первой встрече с новыми данными.
Инструменты калибровки: от простого к надежному
Как практически найти эту золотую середину? Есть несколько подходов, и выбор зависит от объема ваших данных и ресурсов.
- Разделение на обучающую и тестовую выборки (Hold-out). Самый простой метод. Вы берете, например, 80% данных для обучения и 20% оставляете в резерве для проверки. Строите модель, проверяете её на резерве. Если ошибка высокая - усложняете модель. Если низкая, но на новых данных она скачет - возможно, вы переборщили. Минус метода в том, что результат сильно зависит от того, какие именно 20% попали в тест. Один неудачный рандом может ввести вас в заблуждение.
- Перекрестная проверка (Cross-validation). Здесь всё серьезнее. Данные делятся на K частей (фолдов). Модель обучается K раз, каждый раз используя один фолд для проверки и остальные для обучения. Затем результаты усредняются. Этот метод дает гораздо более стабильную оценку способности модели к обобщению. Для небольших датасетов это практически обязательный стандарт, так как он позволяет использовать все данные и для обучения, и для валидации.
- Регуляризация. Вместо того чтобы просто добавлять параметры, мы штрафуем модель за их количество или величину. Методы вроде Lasso или Ridge автоматически отсекают лишние признаки, не давая модели стать чрезмерно сложной. Это мощный способ автоматической калибровки, который часто эффективнее ручного перебора степеней полинома.
| Метод | Надежность оценки | Вычислительные затраты | Когда использовать |
|---|---|---|---|
| Hold-out (70/30) | Низкая (высокая дисперсия результата) | Минимальные | Быстрые прототипы, большие объемы данных |
| K-Fold Cross-validation | Высокая (стабильная оценка) | Средние/Высокие | Стандартная практика, средние датасеты |
| Leave-One-Out CV | Максимальная (минимальное смещение) | Очень высокие | Маленькие датасеты, критичная точность |
Не только метрики: роль контекста и интерпретируемости
Часто забывают, что калибровка сложности - это не только математический оптимум. Иногда самая точная по метрикам модель оказывается непригодной для бизнеса. Почему? Потому что она не объяснима. Если ваша нейросеть со 100 слоями предсказывает отток клиентов чуть точнее, чем простая логистическая регрессия, но маркетологи не могут понять, почему клиент уходит, эта сложность вам не нужна. В таких случаях сознательное занижение сложности ради прозрачности решений оправдано.
Есть и обратная ситуация. В задачах компьютерного зрения или обработки естественного языка простые модели физически не могут уловить структуру данных. Там завышение сложности необходимо, иначе качество будет неприемлемым. Поэтому всегда спрашивайте себя: какова цель использования модели? Нужен ли мне черный ящик с максимальной точностью, или белый ящик с приемлемой точностью, который можно объяснить руководству?
Практические шаги для правильной калибровки
Чтобы не гадать, действуйте по алгоритму:
- Начните с простого. Постройте базовую модель (например, линейную регрессию). Посмотрите на ошибки. Если они огромны на тренировке - модель слишком проста, усложняйте.
- Используйте валидацию. Не смотрите только на тренировочную ошибку. Она обманчива. Всегда держите отдельный набор данных, который модель никогда не видела, или используйте кросс-валидацию.
- Меняйте сложность постепенно. Увеличивайте количество признаков или степень полинома шагами. Отслеживайте, как меняется разница между ошибкой обучения и ошибкой проверки. Резкое расхождение - сигнал тревоги.
- Проверяйте устойчивость. Запустите процедуру несколько раз с разными разбиениями данных. Если оптимальная сложность скачет от запуска к запуску, значит, данных мало или они очень зашумлены.
Помните про эффект «переобучения на валидации». Если вы бесконечно крутите ручки настроек, глядя на одну и ту же валидационную выборку, вы рискуете подстроить модель под неё. Идеально иметь третью, финальную тестовую выборку, которую вы откроете только один раз в самом конце.
FAQ: Частые вопросы о калибровке сложности
Как отличить переобучение от недообучения по графикам?
При недообучении обе ошибки (обучения и проверки) высоки и идут параллельно друг другу, не снижаясь существенно при усложнении модели. При переобучении ошибка обучения стремится к нулю, а ошибка проверки растет после достижения минимума, образуя большой разрыв («разрыв») между двумя кривыми.
Достаточно ли одного метода валидации для выбора сложности?
Нет. Простое разделение (hold-out) может дать ложноположительный или ложноотрицательный результат из-за специфики случайного разбиения. Кросс-валидация (особенно k-fold) предпочтительнее, так как она снижает дисперсию оценки качества модели и делает вывод о сложности более устойчивым.
Влияет ли размер датасета на выбор оптимальной сложности?
Да, напрямую. Чем меньше данных, тем проще должна быть модель, чтобы избежать переобучения. На больших датасетах можно позволить себе более сложные архитектуры (например, глубокие нейросети), так как есть достаточно примеров, чтобы обучить большое количество параметров без запоминания шума.
Что такое регуляризация и как она помогает калибровать сложность?
Регуляризация - это техника штрафования модели за сложность (обычно за сумму квадратов весов или их абсолютные значения). Она заставляет модель игнорировать слабые признаки и предотвращает чрезмерную подстройку под обучающие данные, фактически ограничивая эффективную сложность модели без явного удаления параметров.
Можно ли исправить переобученную модель без изменения её архитектуры?
Частично. Можно добавить больше данных (если возможно), применить методы аугментации данных, использовать dropout (в нейросетях) или усилить регуляризацию. Однако если архитектура изначально избыточна для задачи, радикальное изменение структуры (упрощение) часто бывает более эффективным решением.
8 Комментарии
Алексей Иванов
сентября 19, 2026 AT 08:06Слушайте, коллеги, давайте сразу к делу. Статья толковая, но я бы добавил одну вещь, которую часто упускают новички: не гонитесь за идеальной метрикой на валидации любой ценой.
Когда вы работаете с реальными бизнес-задачами, интерпретируемость модели часто важнее лишнего процента точности. Я видел проекты, где сложные ансамбли деревьев решений давали прирост в 0.5% AUC, но стоили компании огромных денег на поддержку и объяснение результатов заказчику. В итоге мы вернулись к логистической регрессии с хорошими признаками, и все были счастливы.
Калибровка сложности - это не только про математику, это про здравый смысл и понимание того, кто будет использовать вашу модель. Если маркетолог не может понять, почему модель считает клиента рискованным, он просто перестанет ей доверять. Поэтому всегда начинайте с простого baseline, как написано в статье, и усложняйте только тогда, когда есть четкое обоснование для каждого дополнительного параметра.
Artem Zinchenko
сентября 20, 2026 AT 01:17Ох, эта вечная дилемма... Мы пытаемся поймать неуловимую истину данных, но данные шепчут нам ложь через шум.
Вы говорите о балансе, но баланс - это иллюзия стабильности в мире хаоса. Модель, которая идеально подстраивается под обучающую выборку, подобна актеру, который выучил роль дословно, но не понимает смысла пьесы. Он блещет на репетициях, но на премьере перед живой аудиторией его игра рассыпается в прах.
А недообученная модель? Это глухой человек, который слышит только громкие крики, игнорируя тонкую музыку речи. Оба пути ведут к заблуждению.
Настоящее мастерство заключается не в выборе между сложностью и простотой, а в осознании того, что сама природа данных сопротивляется нашему желанию их упростить или усложнить. Мы навязываем им структуру, а они отвечают нам энтропией.
Регуляризация - это лишь попытка укротить эту стихию штрафом, но разве можно оштрафовать хаос?
Иногда мне кажется, что мы строим эти модели, чтобы успокоить собственную тревогу перед неизвестностью будущего.
Но будущее остается туманным, каким бы сложным ни был наш алгоритм.
Мы обманываем себя цифрами, считая, что контроль над ошибкой равен контролю над реальностью.
Это трагедия нашего времени: мы знаем всё о дисперсии и смещении, но ничего не знаем о смысле.
Золотая середина существует только в наших мечтах, в реальности же мы всегда скатываемся в крайности.
Будьте осторожны со своими моделями, они отражают не мир, а ваши страхи.
Евгений Сирота
сентября 21, 2026 AT 11:09Статья хорошая, но поверхностная.
Таблица методов оценки устарела еще лет пять назад.
Сейчас никто не использует простой hold-out для чего-то серьезного.
Даже k-fold считается слишком дорогим для больших данных.
Все давно перешли на bootstrapping или более продвинутые схемы валидации.
Упоминание leave-one-out для маленьких датасетов тоже выглядит наивно.
На практике LOO дает очень высокую дисперсию оценки.
Лучше использовать repeated k-fold.
И вообще, фокус должен быть не на методах валидации, а на feature engineering.
Хорошие признаки делают модель устойчивой независимо от сложности.
Если признаки плохие, никакая калибровка не спасет.
Автор явно теоретик, мало работавший с продакшеном.
Dmitry Sklema
сентября 21, 2026 AT 23:59Полностью согласен с тезисом о том, что нужно начинать с простого.
Но хочу добавить важный нюанс про регуляризацию.
Lasso и Ridge действительно помогают, но они работают линейно.
В задачах с нелинейными зависимостями, которые сейчас повсюду, классическая регуляризация часто недостаточна.
Например, если у вас есть взаимодействие признаков, которое критично для прогноза, Lasso может его убить как шум.
Поэтому важно понимать природу данных перед выбором метода калибровки.
Иначе вы можете получить стабильную, но бесполезную модель.
Так что статья полезна для базы, но требует дополнений про современные методы вроде elastic net или даже нейросетевой регуляризации через dropout как аналог L2.
Алина Герасимова
сентября 22, 2026 AT 04:42Ну наконец-то кто-то пишет по делу!
Мне надоели эти гуру, которые считают, что чем сложнее модель, тем она умнее.
Глубокие нейросети - это часто просто способ оправдать высокие зарплаты дата-сайентистов.
В 90% случаев линейная модель с нормальными фичами работает лучше и быстрее.
А эти ваши кросс-валидации жрут время как ненормальные.
Я раньше тратила дни на подбор гиперпараметров, а потом выяснялось, что проблема была в грязных данных.
Чистка данных важнее калибровки сложности, запомните это.
И хватит уже усложнять простые вещи ради понтов.
Простота - это добродетель, а не признак слабости.
Если ваш менеджер не понимает модель, значит, вы плохо поработали.
Контекст решает всё, а не математика.
Мария Черненкова
сентября 22, 2026 AT 10:45Мария, вы так категоричны, но в этом есть доля правды.
Действительно, чистка данных часто приносит больше пользы, чем тюнинг гиперпараметров.
Но сказать, что кросс-валидация бессмысленна, было бы несправедливо.
Она защищает нас от самообмана, когда мы случайно хорошо разбились на тестовой выборке.
Я тоже сталкивалась с ситуациями, когда модель выглядела отлично на валидации, но падала в проде.
Именно тогда кросс-валидация помогала увидеть разброс результатов.
Так что не стоит выбрасывать инструменты из-за одного неудачного опыта.
Важно находить баланс и здесь тоже.
Вячеслав Шаров
сентября 23, 2026 AT 02:55Интересный взгляд на проблему, особенно часть про контекст и интерпретируемость.
В моей практике, связанной с международными проектами, разница в подходах к сложности модели сильно зависит от культурных особенностей команды и заказчика.
Например, в некоторых европейских компаниях прозрачность модели является юридическим требованием (GDPR и подобные нормы), поэтому там переобучение сложных моделей автоматически отсеивается на этапе дизайна системы.
В то же время в стартапах с быстрым ростом часто жертвуют интерпретируемостью ради скорости получения первых инсайтов, даже если это приводит к нестабильности прогнозов в долгосрочной перспективе.
Кроме того, стоит отметить, что понятие "золотой середины" может меняться во времени: модель, оптимальная сегодня, может стать переобученной завтра из-за дрейфа данных.
Поэтому калибровка сложности - это не одноразовая процедура, а непрерывный процесс мониторинга и адаптации.
Также хотелось бы упомянуть роль человеческой ошибки в оценке сложности: иногда мы переоцениваем способность простых моделей захватывать нелинейные зависимости, если не используем достаточное количество качественных признаков.
В целом, статья заставляет задуматься о том, что техническая оптимизация должна идти рука об руку с организационными и этическими аспектами использования ИИ.
Спасибо автору за поднятие этих важных вопросов, которые выходят за рамки чистой статистики.
Было бы интересно увидеть продолжение про автоматизированные методы поиска оптимальной сложности (AutoML) и их ограничения.
Ведь автоматизация процесса калибровки тоже имеет свою цену и свои риски.
Жду новых материалов на эту тему!
Nastya Susoeva
сентября 24, 2026 AT 19:06Эта тема вызывает у меня настоящую боль.
Помню проект, где мы потратили месяцы на создание монструозной архитектуры, которая выдавала красивые цифры на бумаге.
А в жизни она ломалась на каждом втором запросе, потому что не видела элементарных вещей.
Переобучение - это форма гордыни алгоритма, он думает, что знает всё.
Недообучение - это его лень, ему проще не видеть деталей.
Мы же, люди, ответственны за то, чтобы научить их скромности.
Без этого баланса любые метрики - просто красивая ложь.